Tips Mengoptimalkan GPU untuk AI Lokal, Cara Mempercepat Inferensi dan Menekan Beban Sistem
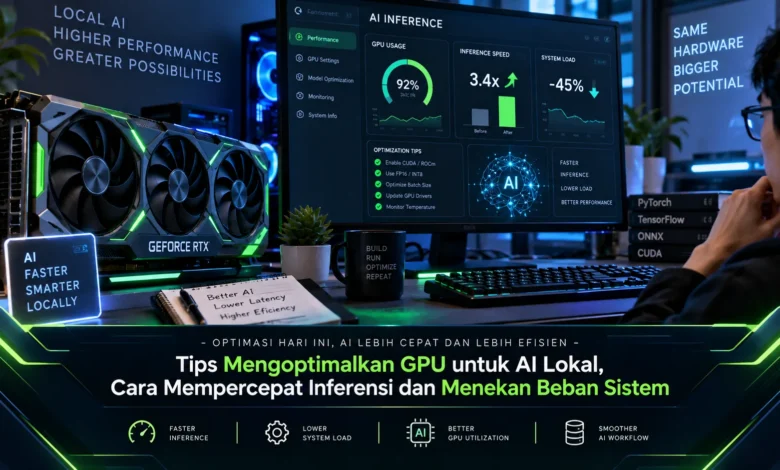
Menjalankan AI secara lokal semakin menarik karena pengguna dapat memproses model langsung melalui komputer sendiri tanpa selalu bergantung pada layanan cloud. Namun, performa AI lokal sangat dipengaruhi oleh kemampuan GPU, kapasitas VRAM, ukuran model, serta konfigurasi software yang digunakan. Dengan optimasi yang tepat, inferensi dapat berjalan lebih cepat sekaligus menjaga beban sistem tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI ketika model lokal mulai digunakan untuk berbagai kebutuhan produktivitas dan eksperimen.
Kenali Kebutuhan Model Sebelum Mengoptimalkan GPU
Hal utama sebelum melakukan optimasi GPU adalah memahami karakteristik model yang akan dijalankan. Setiap arsitektur kecerdasan buatan memiliki karakter penggunaan GPU yang berbeda, karena model dengan parameter lebih banyak tidak selalu ideal untuk perangkat lokal. Arsitektur yang cocok dengan spesifikasi hardware dapat membantu menghasilkan performa yang lebih nyaman untuk penggunaan sehari hari.
Kapasitas memory GPU perlu diperiksa sebelum model dimuat karena bobot model serta data sementara harus berada di memory ketika diproses. Apabila memory GPU hampir seluruhnya terpakai, workload dapat mengalami tekanan memory saat konteks maupun data bertambah. Dengan memilih ukuran model secara realistis, pengguna dapat membangun konfigurasi TEKNOLOGI AI lokal yang lebih efisien.
Manajemen Memory Menjadi Kunci Performa AI Lokal
VRAM merupakan salah satu sumber daya paling penting saat model kecerdasan buatan diproses langsung pada perangkat. Ketika model berhasil dimuat sepenuhnya pada GPU, pemrosesan berpotensi berlangsung lebih cepat dibandingkan ketika terlalu banyak data harus berpindah antara GPU dan memory sistem.
Mengurangi program lain yang menggunakan akselerasi GPU dapat membuat kapasitas GPU yang tersedia menjadi lebih besar. Aplikasi visual, software editing, browser, serta program lain yang memanfaatkan GPU dapat menggunakan sebagian VRAM meskipun bukan bagian dari workload AI. Menjaga sebagian VRAM tetap tersedia juga dapat membantu sistem menghadapi perubahan kebutuhan memory. Pendekatan pengelolaan memory ini bisa meningkatkan kenyamanan penggunaan tanpa membutuhkan GPU baru.
Model AI Lokal Bisa Lebih Efisien dengan Precision yang Tepat
Quantization menjadi salah satu teknik yang banyak digunakan ketika ingin menekan kebutuhan sumber daya model. Metode tersebut menyimpan parameter menggunakan format numerik yang lebih ringkas, sehingga kebutuhan memory dapat turun secara signifikan. Format dengan precision lebih rendah dapat membantu pengguna menjalankan model lokal menggunakan sumber daya yang lebih realistis.
Tingkat pengurangan precision sebaiknya tidak dipilih secara sembarangan. Representasi dengan bit lebih sedikit dapat memberikan penghematan VRAM lebih besar, tetapi kualitas output pada sebagian model dapat mengalami perubahan. Karena itu, beberapa tingkat quantization dapat diuji terlebih dahulu untuk menemukan titik seimbang antara kecepatan, kualitas, dan penggunaan memory.
Sesuaikan Beban Inferensi dengan Kapasitas Perangkat
Di samping parameter model, jumlah informasi yang diproses dalam satu konteks dapat meningkatkan penggunaan memory. Context yang semakin panjang dapat membuat penggunaan VRAM bertambah seiring meningkatnya data yang harus dipertahankan. Jika kebutuhan penggunaan tidak memerlukan konteks sangat panjang, membatasi konteks sesuai kebutuhan dapat membuat penggunaan GPU lebih efisien.
Jumlah data yang diproses secara bersamaan turut memengaruhi performa. Ukuran batch yang berlebihan dapat meningkatkan konsumsi memory secara cepat, sedangkan ukuran yang sangat rendah dapat mengurangi efisiensi pemrosesan. Ukuran batch dapat diuji dari konfigurasi rendah menuju lebih tinggi sambil memantau penggunaan VRAM dan kecepatan inferensi. Pendekatan berbasis pengujian membuat optimalisasi TEKNOLOGI AI menjadi lebih terukur.
Framework yang Tepat Bisa Meningkatkan Performa AI Lokal
Performa AI lokal tidak hanya ditentukan oleh GPU. Framework, backend komputasi, driver, serta konfigurasi software memiliki peranan penting dalam menentukan efisiensi sistem. Software yang mampu memanfaatkan akselerasi GPU secara baik dapat membantu GPU menjalankan operasi model secara lebih efektif.
Pengguna dapat menentukan seberapa banyak bagian model yang diproses melalui kartu grafis. Ketika kartu grafis memiliki ruang memory yang memadai, lebih banyak komponen model dapat ditempatkan pada GPU sehingga sebagian besar komputasi berat dapat ditangani GPU. Apabila kapasitas memory grafis tidak mencukupi, pembagian komputasi dapat dilakukan antara GPU dengan sistem utama, walaupun perpindahan data berpotensi mengurangi performa. Mengatur offloading secara seimbang berpotensi meningkatkan efisiensi tanpa memaksakan kapasitas GPU.
Monitoring GPU Membantu Menjaga Performa AI Lokal
Penyesuaian konfigurasi sebaiknya didasarkan pada hasil monitoring. Utilisasi GPU, konsumsi VRAM, penggunaan CPU, RAM, temperatur, serta kecepatan inferensi dapat dipantau selama workload berjalan. Informasi tersebut membantu menunjukkan bagian mana yang menjadi bottleneck.
Jika GPU memiliki utilisasi rendah tetapi CPU terus bekerja tinggi, konfigurasi offloading dapat menjadi salah satu bagian yang perlu diperiksa. Apabila memory GPU terus berada pada kapasitas maksimum, konfigurasi model dan kebutuhan memory sebaiknya ditinjau kembali. Temperatur yang terlalu tinggi dalam waktu lama juga dapat memengaruhi konsistensi performa. Dengan memahami bottleneck terlebih dahulu, pengguna dapat melakukan optimasi pada bagian yang benar.
Kesimpulan
Mengoptimalkan GPU untuk AI lokal membutuhkan keseimbangan antara ukuran model, kapasitas VRAM, konfigurasi inferensi, dan kemampuan sistem. Pemilihan model realistis, manajemen VRAM, precision yang efisien, konfigurasi context, batch, serta pembagian workload berpotensi memberikan respons lebih cepat tanpa membebani perangkat secara berlebihan.
Monitoring tetap menjadi bagian penting dari seluruh proses karena kombinasi GPU, CPU, RAM, model, dan software tidak selalu sama. Perkembangan TEKNOLOGI AI lokal yang semakin cepat membuat optimasi sumber daya semakin relevan bagi pengguna. Dengan membandingkan konfigurasi berdasarkan kecepatan serta penggunaan memory, kombinasi performa serta efisiensi yang ideal dapat ditemukan tanpa sekadar menebak. Pembaca dapat membandingkan beberapa pengaturan untuk menemukan kombinasi terbaik bagi workload AI lokal masing masing.