Tips Mengoptimalkan GPU untuk AI Lokal, Cara Mempercepat Inferensi dan Menekan Beban Sistem
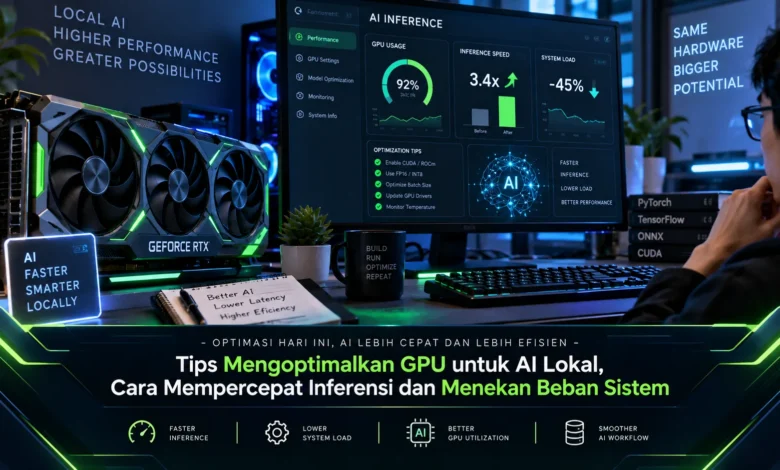
Menjalankan AI secara lokal semakin menarik karena pengguna dapat memproses model langsung melalui komputer sendiri tanpa selalu bergantung pada layanan cloud. Namun, performa AI lokal sangat dipengaruhi oleh kemampuan GPU, kapasitas VRAM, ukuran model, serta konfigurasi software yang digunakan. Dengan optimasi yang tepat, inferensi dapat berjalan lebih cepat sekaligus menjaga beban sistem tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI ketika model lokal mulai digunakan untuk berbagai kebutuhan produktivitas dan eksperimen.
Kenali Kebutuhan Model Sebelum Mengoptimalkan GPU
Langkah awal dalam mengoptimalkan GPU untuk AI lokal ialah mengetahui kebutuhan komputasi dari model yang digunakan. Masing masing model AI membutuhkan kapasitas memory serta kemampuan pemrosesan yang tidak sama, sehingga model berukuran besar belum tentu menjadi pilihan paling efisien. Arsitektur yang cocok dengan spesifikasi hardware biasanya dapat memberikan inferensi yang lebih stabil.
Jumlah VRAM pada kartu grafis menjadi salah satu faktor penting karena parameter model, cache, dan data sementara membutuhkan ruang selama inferensi. Jika penggunaan VRAM terlalu mendekati kapasitas maksimum, workload dapat mengalami tekanan memory saat konteks maupun data bertambah. Dengan menyesuaikan model terhadap hardware yang dimiliki, pengguna dapat membangun konfigurasi TEKNOLOGI AI lokal yang lebih efisien.
Atur Penggunaan VRAM untuk Mengurangi Beban Sistem
Memory GPU menjadi salah satu komponen utama saat model kecerdasan buatan diproses langsung pada perangkat. Ketika model berhasil dimuat sepenuhnya pada GPU, inferensi biasanya dapat berjalan lebih efisien dibandingkan ketika terlalu banyak data harus berpindah antara GPU dan memory sistem.
Menghentikan software yang mengonsumsi memory grafis secara tidak penting dapat membuat kapasitas GPU yang tersedia menjadi lebih besar. Program grafis, browser dengan banyak proses, permainan, dan aplikasi video dapat menggunakan sebagian VRAM meskipun bukan bagian dari workload AI. Memberikan ruang memory cadangan dapat memberikan fleksibilitas ketika ukuran konteks meningkat. Pendekatan pengelolaan memory ini dapat memberikan dampak nyata tanpa harus mengganti hardware.
Model AI Lokal Bisa Lebih Efisien dengan Precision yang Tepat
Pengurangan precision model merupakan strategi yang cukup efektif ketika ingin menekan kebutuhan sumber daya model. Pendekatan ini mengurangi precision yang digunakan untuk merepresentasikan bobot model, yang membuat konsumsi VRAM berpotensi menjadi lebih rendah. Model yang telah dikuantisasi dapat membuat model berukuran besar lebih mudah dijalankan pada GPU konsumen.
Pemilihan tingkat quantization tetap perlu disesuaikan dengan kebutuhan. Precision yang semakin rendah dapat menghemat memory lebih banyak, meski akurasi maupun konsistensi keluaran dapat berubah tergantung model. Karena itu, pengujian pada workload nyata menjadi langkah yang penting supaya konfigurasi akhir memberikan efisiensi tanpa mengorbankan hasil secara berlebihan.
Sesuaikan Beban Inferensi dengan Kapasitas Perangkat
Bukan hanya bobot model, ukuran konteks memiliki pengaruh terhadap konsumsi sumber daya. Konteks dengan jumlah token lebih besar dapat membutuhkan kapasitas tambahan untuk menyimpan cache selama proses generasi. Jika kebutuhan penggunaan tidak memerlukan konteks sangat panjang, membatasi konteks sesuai kebutuhan dapat membuat penggunaan GPU lebih efisien.
Jumlah data yang diproses secara bersamaan turut memengaruhi performa. Ukuran batch yang berlebihan dapat meningkatkan konsumsi memory secara cepat, sementara batch yang terlalu kecil tidak selalu memanfaatkan kemampuan hardware secara maksimal. Pengguna dapat menaikkan batch secara bertahap dengan memperhatikan perubahan konsumsi memory serta throughput. Strategi eksperimen seperti ini lebih efektif untuk menemukan konfigurasi optimal.
Optimalkan Software dan GPU Offloading untuk Mempercepat Inferensi
Kecepatan inferensi bukan hanya bergantung pada spesifikasi kartu grafis. Lingkungan software, backend pemrosesan, driver, serta konfigurasi inferensi memiliki peranan penting dalam menentukan efisiensi sistem. Software yang mampu memanfaatkan akselerasi GPU secara baik berpotensi meningkatkan throughput sekaligus menjaga penggunaan memory.
GPU offloading juga dapat disesuaikan dengan kapasitas perangkat. Apabila kapasitas memory GPU masih tersedia, lebih banyak komponen model dapat ditempatkan pada GPU agar proses tidak terlalu bergantung pada prosesor utama. Apabila kapasitas memory grafis tidak mencukupi, porsi tertentu dapat diproses melalui memory sistem dan prosesor, meskipun kecepatan inferensi dapat menurun. Menemukan pembagian yang tepat dapat membantu memperoleh performa terbaik dari perangkat yang tersedia.
Identifikasi Hambatan Sistem Sebelum Mengubah Hardware
Pengaturan performa akan lebih tepat jika menggunakan informasi penggunaan perangkat. Pemakaian kartu grafis, memory GPU, prosesor, memory sistem, suhu, dan throughput dapat dipantau selama workload berjalan. Data monitoring tersebut membantu menunjukkan bagian mana yang menjadi bottleneck.
Ketika aktivitas GPU rendah sedangkan penggunaan CPU mendekati batas, konfigurasi offloading dapat menjadi salah satu bagian yang perlu diperiksa. Ketika konsumsi VRAM sangat tinggi, quantization, context, cache, maupun ukuran model dapat dievaluasi. Suhu GPU yang terus meningkat berpotensi membuat kecepatan tidak stabil. Dengan memahami bottleneck terlebih dahulu, pengguna dapat melakukan optimasi pada bagian yang benar.
Kesimpulan
Mengoptimalkan GPU untuk AI lokal membutuhkan keseimbangan antara ukuran model, kapasitas VRAM, konfigurasi inferensi, dan kemampuan sistem. Pemilihan model realistis, manajemen VRAM, precision yang efisien, konfigurasi context, batch, serta pembagian workload dapat membantu mempercepat inferensi sekaligus mengurangi tekanan terhadap sistem.
Pemantauan performa sebaiknya tetap dilakukan setelah setiap perubahan karena setiap perangkat memiliki karakteristik yang berbeda. Kemajuan TEKNOLOGI kecerdasan buatan pada perangkat personal membuat optimasi sumber daya semakin relevan bagi pengguna. Melalui eksperimen terukur terhadap model dan pengaturan sistem, pengguna dapat memperoleh pengalaman inferensi yang lebih responsif dengan perangkat yang sudah dimiliki. Pengguna dapat menguji konfigurasi satu per satu agar perubahan performa lebih mudah diukur.